월 식비 예산을 입력하면 레시피의 재료를 뽑아 마켓컬리·오아시스마켓의 현재 가격과 비교하고, 예산 안에서 한 달 식단을 짜 주는 서비스입니다. 애플리케이션을 13개 마이크로서비스로 나누고, Docker에서 시작해 Kubernetes를 거쳐 AWS EKS까지 세 단계로 환경을 옮겼습니다.
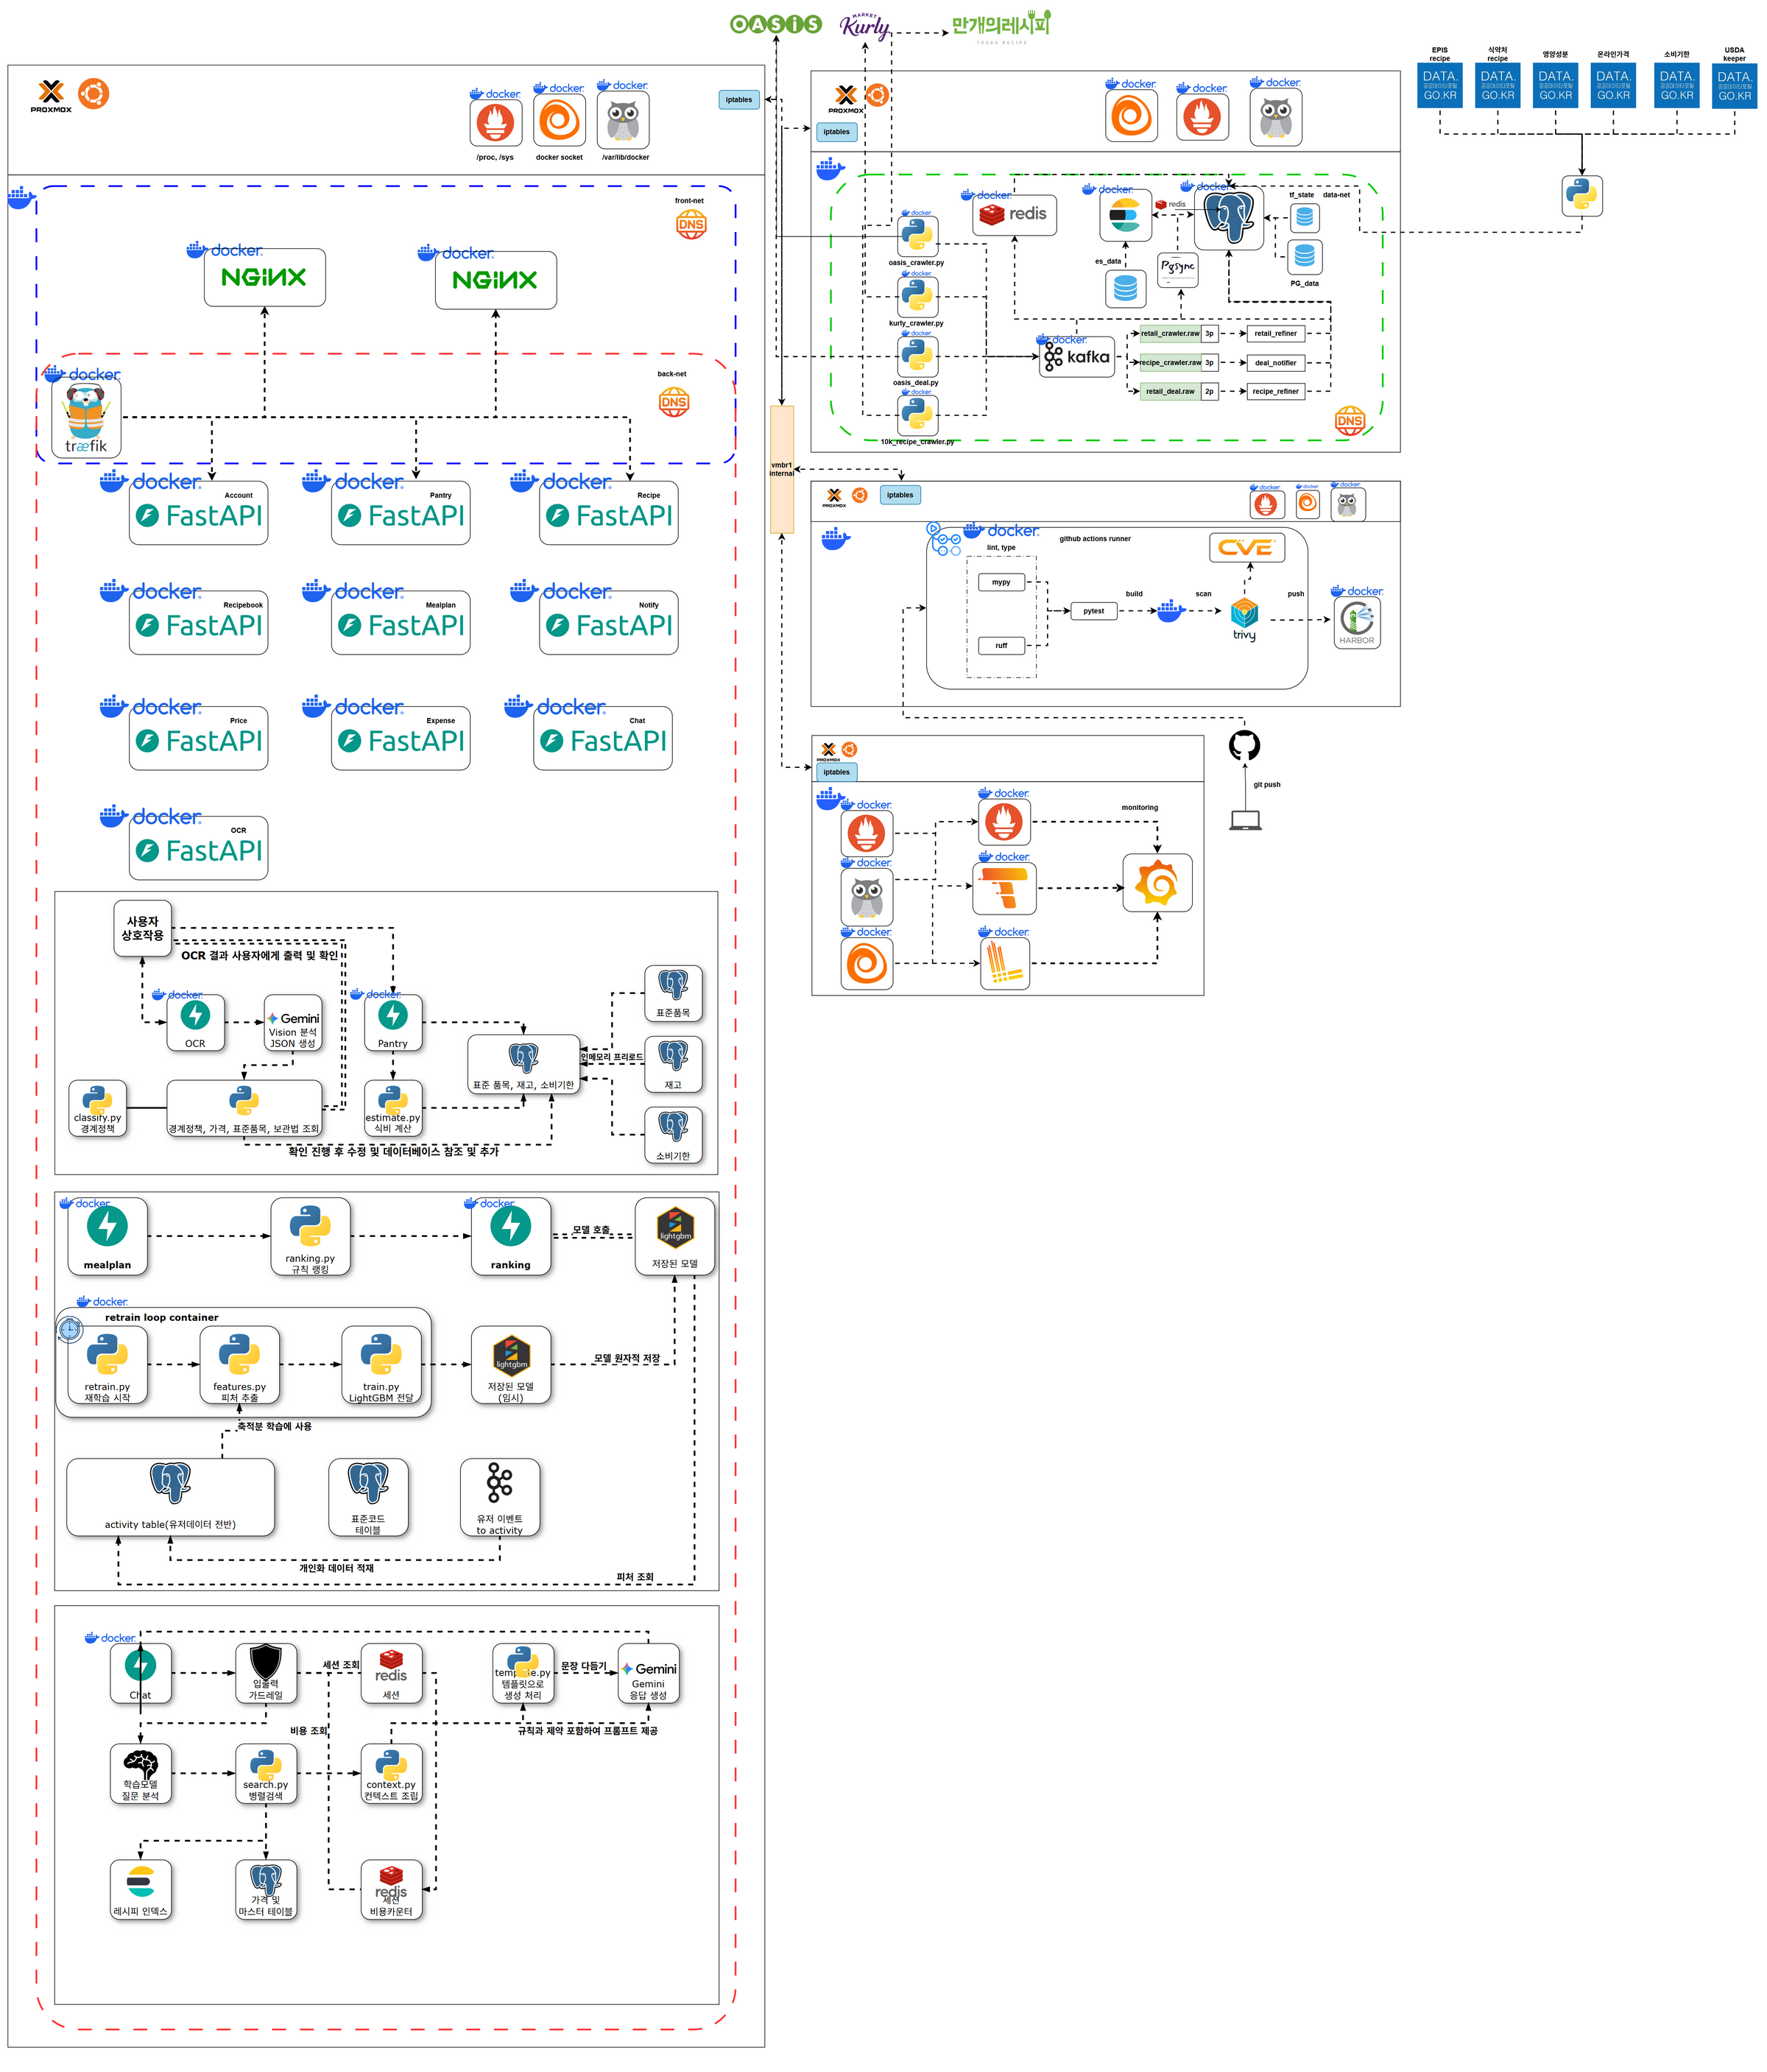
업무 단위로 나눈 서비스를 각각 이미지로 만들고, Compose로 묶어 서버 한 대에서 돌렸습니다. 이 단계의 컨테이너 구성과 CI는 팀원이 설계했고, 저는 백엔드와 프론트엔드 개발을 맡았습니다.
Docker 단계 구성도 (팀원 설계, 클릭하면 원본 크기)
다음 단계로 간 이유: 팀원이 한 부하 시험에서 동시 사용자 약 200명일 때 응답이 8초에서 20초로 늘었는데, CPU는 18%로 여유가 있었습니다. 설정 병목을 풀고 나니 남은 한계는 서버를 늘리는 것이었고, Compose로는 한 서버 안에서만 늘릴 수 있어서 Kubernetes로 옮겼습니다.
Stage 02 · Kubernetes (온프렘)
물리 서버 3대에 5노드 클러스터
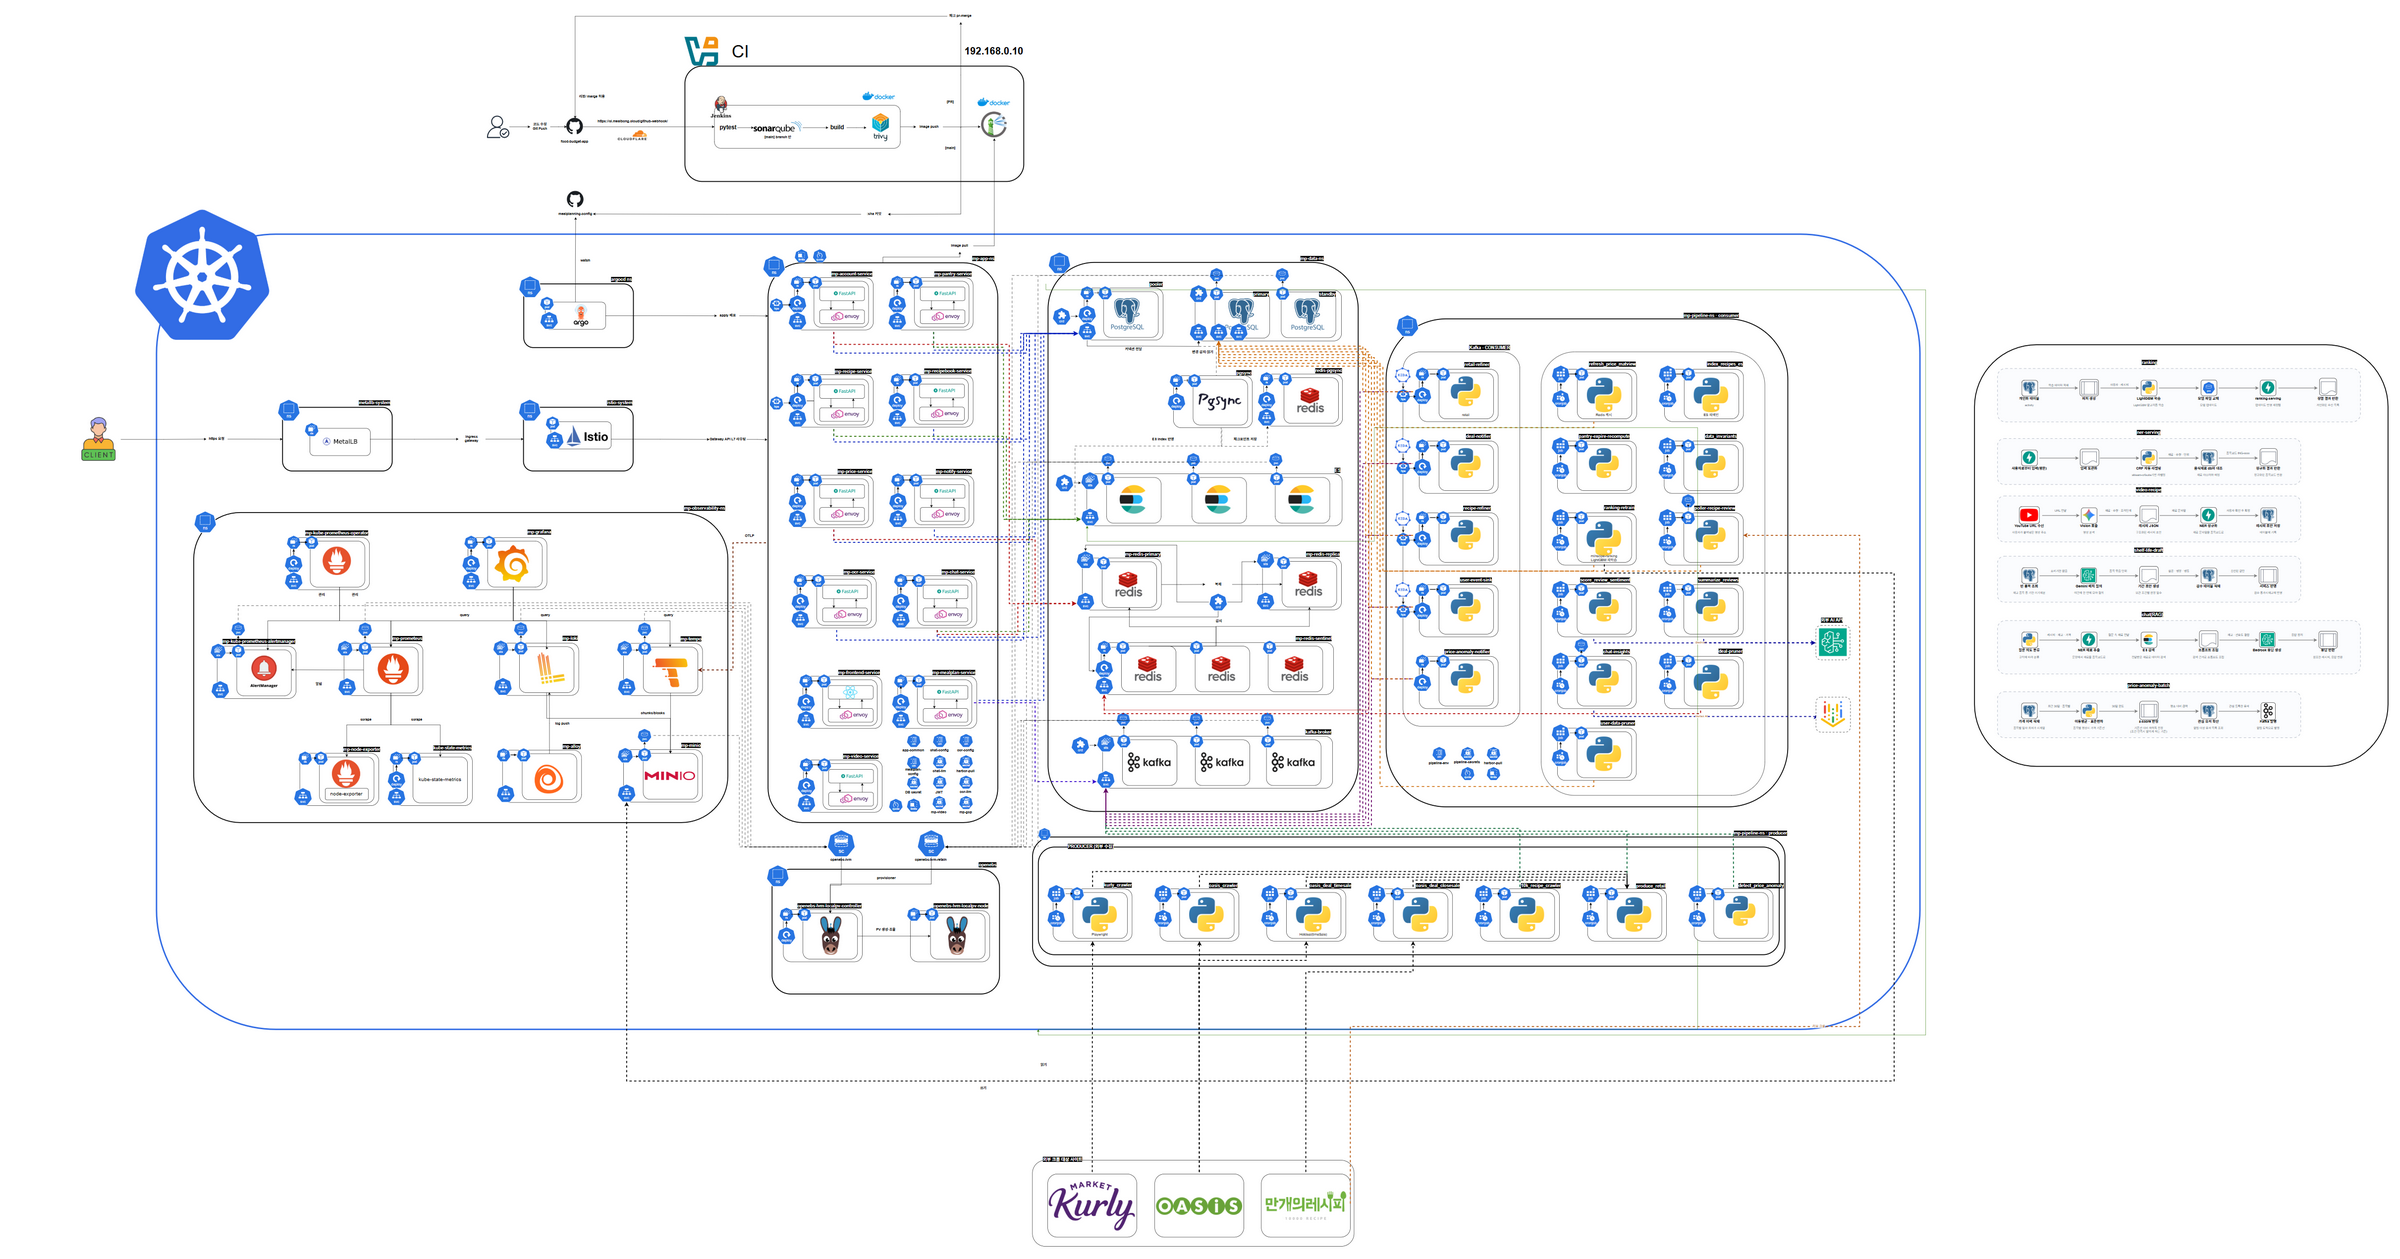
클러스터 구성은 팀원과 같이 정했고 구축은 팀원이 맡았습니다. kubeadm으로 control-plane 1대와 worker 4대를 만들고, 장애가 잦았던 서버를 피해 control-plane을 배치했습니다. 저는 그 위에서 배포 구조와 카나리 배포, 외부 접속, 보안과 백업을 맡았습니다.
배포 구조
앱 코드 레포와 별도로 배포 설정 레포를 만들고, 클러스터 안의 ArgoCD가 그 레포를 보고 클러스터를 맞추게 했습니다. CI가 새 이미지 태그를 앱 레포에 커밋하면 그 커밋이 다시 CI를 부르기 때문에 레포를 나눴고, 덕분에 설정 레포의 커밋 기록이 그대로 배포 기록이 됐습니다.
배포 전략
장애가 나면 영향이 큰 계정·레시피 서비스에 Argo Rollouts Canary를 적용했습니다. 트래픽을 20→50→100%로 옮기면서 5xx 비율과 응답 지연을 자동으로 확인하고, 기준을 넘으면 자동으로 되돌립니다. 메모리가 부족해 새 버전과 구 버전을 동시에 띄우는 Blue-Green은 이 단계에서 쓸 수 없었습니다.
외부 접속
학원 공유기 망이라 포트포워딩을 열 수 없어서, 클러스터 안에서 바깥으로 연결을 여는 Cloudflare Tunnel로 외부 접속을 받았습니다. 서버에 들어오는 포트는 하나도 열지 않았습니다.
보안
네임스페이스 사이 통신은 기본으로 막고 필요한 경로만 네트워크 정책으로 열었습니다. 서비스 간 통신은 Istio mTLS로 암호화했고, 비밀번호 같은 값은 External Secrets로 관리해 매니페스트에 평문이 남지 않게 했습니다. etcd에 저장되는 데이터도 암호화했고, 팀원별로 RBAC을 나눠 각자 필요한 권한만 쓰게 했습니다.
백업
PostgreSQL은 S3로 계속 백업해 최대 5분 전 시점으로 되돌릴 수 있게 했고, etcd와 이미지, 소스도 따로 백업했습니다. 검색용 Elasticsearch는 PostgreSQL에서 다시 만들 수 있어서 백업하지 않고, 다시 만들 수 없는 사용자 데이터에 집중했습니다. 백업 파일이 있는 것으로 끝내지 않고 실제로 복원해 보는 것까지 확인했습니다.
백업 알림
백업마다 S3에 최신 파일이 실제로 있는지를 15분마다 재서 알림을 걸었습니다. 직접 점검하다가, 이미지 백업이 자격증명 문제로 전부 실패하고 있는데도 빌드는 성공으로 끝나고 있던 걸 찾았습니다. 작업이 성공했는지만 보는 알림으로는 이런 경우를 잡을 수 없어서 이 방식으로 바꿨습니다.
팀원과 함께
네트워크(Cilium)와 서비스 메시(Istio), 외부 진입(MetalLB)은 어떤 도구와 모드를 쓸지 같이 정하고 팀원이 설치했습니다. 별도 VM에 있던 데이터베이스를 클러스터 안 오퍼레이터로 옮기는 작업도 팀원이 진행했습니다.
Kubernetes 설계도: 진입 경로, 데이터 계층, 관측 스택, 배치 파이프라인 (클릭하면 원본 크기)
다음 단계로 간 이유: 서버를 늘릴 수 없어서 어떤 서비스를 어디에 둘지가 늘 문제였고, 과정의 마지막 목표도 클라우드 이전이었습니다. 같은 구성을 AWS에 다시 만들어 필요할 때 노드를 늘릴 수 있게 했습니다.
CI/CD · 사람이 하는 일과 자동으로 도는 일
머지한 뒤로는 사람 손을 거치지 않는 배포
사람이 하는 일은 PR을 올리고, 팀원이 리뷰하고, main에 머지하는 데까지입니다. 머지한 뒤로는 아래 순서가 자동으로 돌아가고, 중간에 검사를 통과하지 못하면 그 자리에서 멈춥니다.
빌드 시작GitHub 웹훅이 Jenkins를 깨우고, 바뀐 서비스만 골라 빌드합니다.
단위 테스트pytest가 실패하면 그 서비스는 여기서 멈춥니다.
코드 품질 측정SonarQube로 품질을 기록합니다. 배포를 막지는 않습니다.
이미지 빌드서비스 이미지를 만듭니다.
취약점 검사Trivy가 고칠 수 있는 심각(CRITICAL) 취약점을 찾으면 멈춥니다.
레지스트리 등록통과한 이미지를 Harbor에 올립니다.
배포 설정 갱신배포 설정 레포에 새 이미지 태그를 커밋합니다.
클러스터 반영ArgoCD가 바뀐 설정을 클러스터에 반영하고, 계정·레시피 서비스는 카나리로 단계적으로 전환합니다.
되돌릴 때는 배포 설정 레포의 태그 커밋을 되돌리면 ArgoCD가 이전 이미지로 맞춥니다. 카나리 중에는 5xx 비율이나 응답 지연이 기준을 넘으면 사람 개입 없이 이전 버전으로 돌아갑니다.
AWS용 이미지는 GitLab CI가 같은 순서로 만들어 ECR에 올렸습니다. EKS 노드가 Graviton(ARM)이라 러너도 Graviton 서버에 두고 arm64 이미지만 빌드했습니다. 여러 아키텍처 이미지를 한 번에 만드는 방식(buildx)은 취약점 검사 전에 이미지를 올리게 돼서 쓰지 않았습니다.
Stage 03 · AWS (EKS)
온프렘을 멈추지 않고 AWS로 옮기기
AWS 인프라는 설계부터 구축까지 제가 맡았고, 데이터 이관(PostgreSQL 데이터 이동과 검색용 Elasticsearch 동기화)은 팀원이 맡았습니다. 옮기는 동안에도 서비스는 온프렘에서 계속 돌아가야 해서, 온프렘 설정은 건드리지 않고 AWS용 설정만 새로 추가했습니다. 배포 설정을 온프렘용과 EKS용으로 나눠서, 한쪽을 고쳐도 다른 쪽에는 영향이 가지 않게 했습니다.
인프라 코드
팀원이 Docker 단계에서 만들어 둔 Terraform 구조 위에 EKS용 스택을 새로 만들고, 클러스터 설정은 Ansible로 올렸습니다. 코드 작성에는 AI 도구를 썼고, 무엇을 만들지와 plan 확인, 적용, 실행 중에 나온 문제 수정은 직접 했습니다. AI와 정리한 설계도 구축 전에 근거를 다시 확인했고, 그 과정에서 바로잡은 것이 아래 결정 기록의 ENI 모드입니다.
결함 기록
데이터와 트래픽이 없는 첫 단계에서 결함을 최대한 털어 내기로 하고, 구축 중 나온 결함 25건을 모두 기록했습니다. 그중 19건은 terraform plan 같은 사전 검사를 통과한 뒤 실제로 실행해서야 드러났습니다. 예를 들어 보안 그룹 설명에 한글을 넣었다가 apply 단계에서 보안 그룹 4개와 거기 연결된 리소스 17개가 만들어지지 않았습니다.
컴퓨트
같은 사양의 Intel 인스턴스보다 20% 정도 저렴한 m7g.xlarge(Graviton) 2대를 평소에 두고, 배포나 부하가 몰릴 때만 Karpenter가 노드를 더 띄우게 했습니다.
CI를 GitLab CE 자체 호스팅으로 옮기면서, 오래 쓰는 액세스 키 대신 OIDC로 그때그때 짧은 토큰을 받게 했습니다. 파드는 IRSA로 각자 필요한 AWS 권한만 받습니다.
보안 알림
계속 운영할 것을 생각해 AWS 쪽 보안 알림을 따로 챙겼습니다. GuardDuty와 CloudTrail 이벤트를 EventBridge와 Lambda로 받아 별도 Slack 채널로 보내는 경로를 클러스터 밖에 만들었습니다.
이관 리허설
데이터 이관 리허설에서 EKS 쪽 데이터베이스 스키마가 온프렘보다 41개 컬럼 모자란 걸 찾았습니다. 온프렘에만 마이그레이션 15개가 더 적용돼 있었기 때문입니다. 그대로 옮겼다면 배포는 성공하고 쿼리만 실행 중에 실패했을 거라, 온프렘 스키마를 그대로 떠서 빠진 테이블과 컬럼을 채우는 스크립트를 만들었습니다.
배포 전략
Canary를 Blue-Green으로 바꿨습니다. 실제 트래픽이 초당 1건 정도라 Canary 20% 단계에서 3분 동안 확인할 수 있는 요청이 34건 정도뿐이었고, 5xx가 한 건만 나와도 3%가 되어 진짜 문제인지 우연인지 가리기 어려웠습니다. Karpenter로 노드를 늘릴 수 있게 되면서 두 벌을 띄울 여유도 생겼습니다. 부하를 건 채로 전환해 보니 승격에 1.8초가 걸렸고, 그동안 들어온 요청 1,409건 중 5xx는 0건이었습니다.
마무리와 이후
프로젝트가 끝난 8월 말에는 앱 12종이 EKS에서 돌고 데이터도 옮겨 둔 상태였습니다. 남은 건 온프렘 쓰기를 잠깐 멈추고 마지막 데이터를 다시 옮긴 뒤 프로덕션 도메인을 EKS로 돌리는 전환 단계였는데, 온프렘도 계속 운영하려고 도메인을 나눠 둔 채 프로젝트를 마쳤습니다. 9월 2일 AWS 인프라를 철거했고, 시연용 서비스는 Lightsail 서버 1대로 옮겨 지금도 운영하고 있습니다(월 비용 약 $690 → $24).
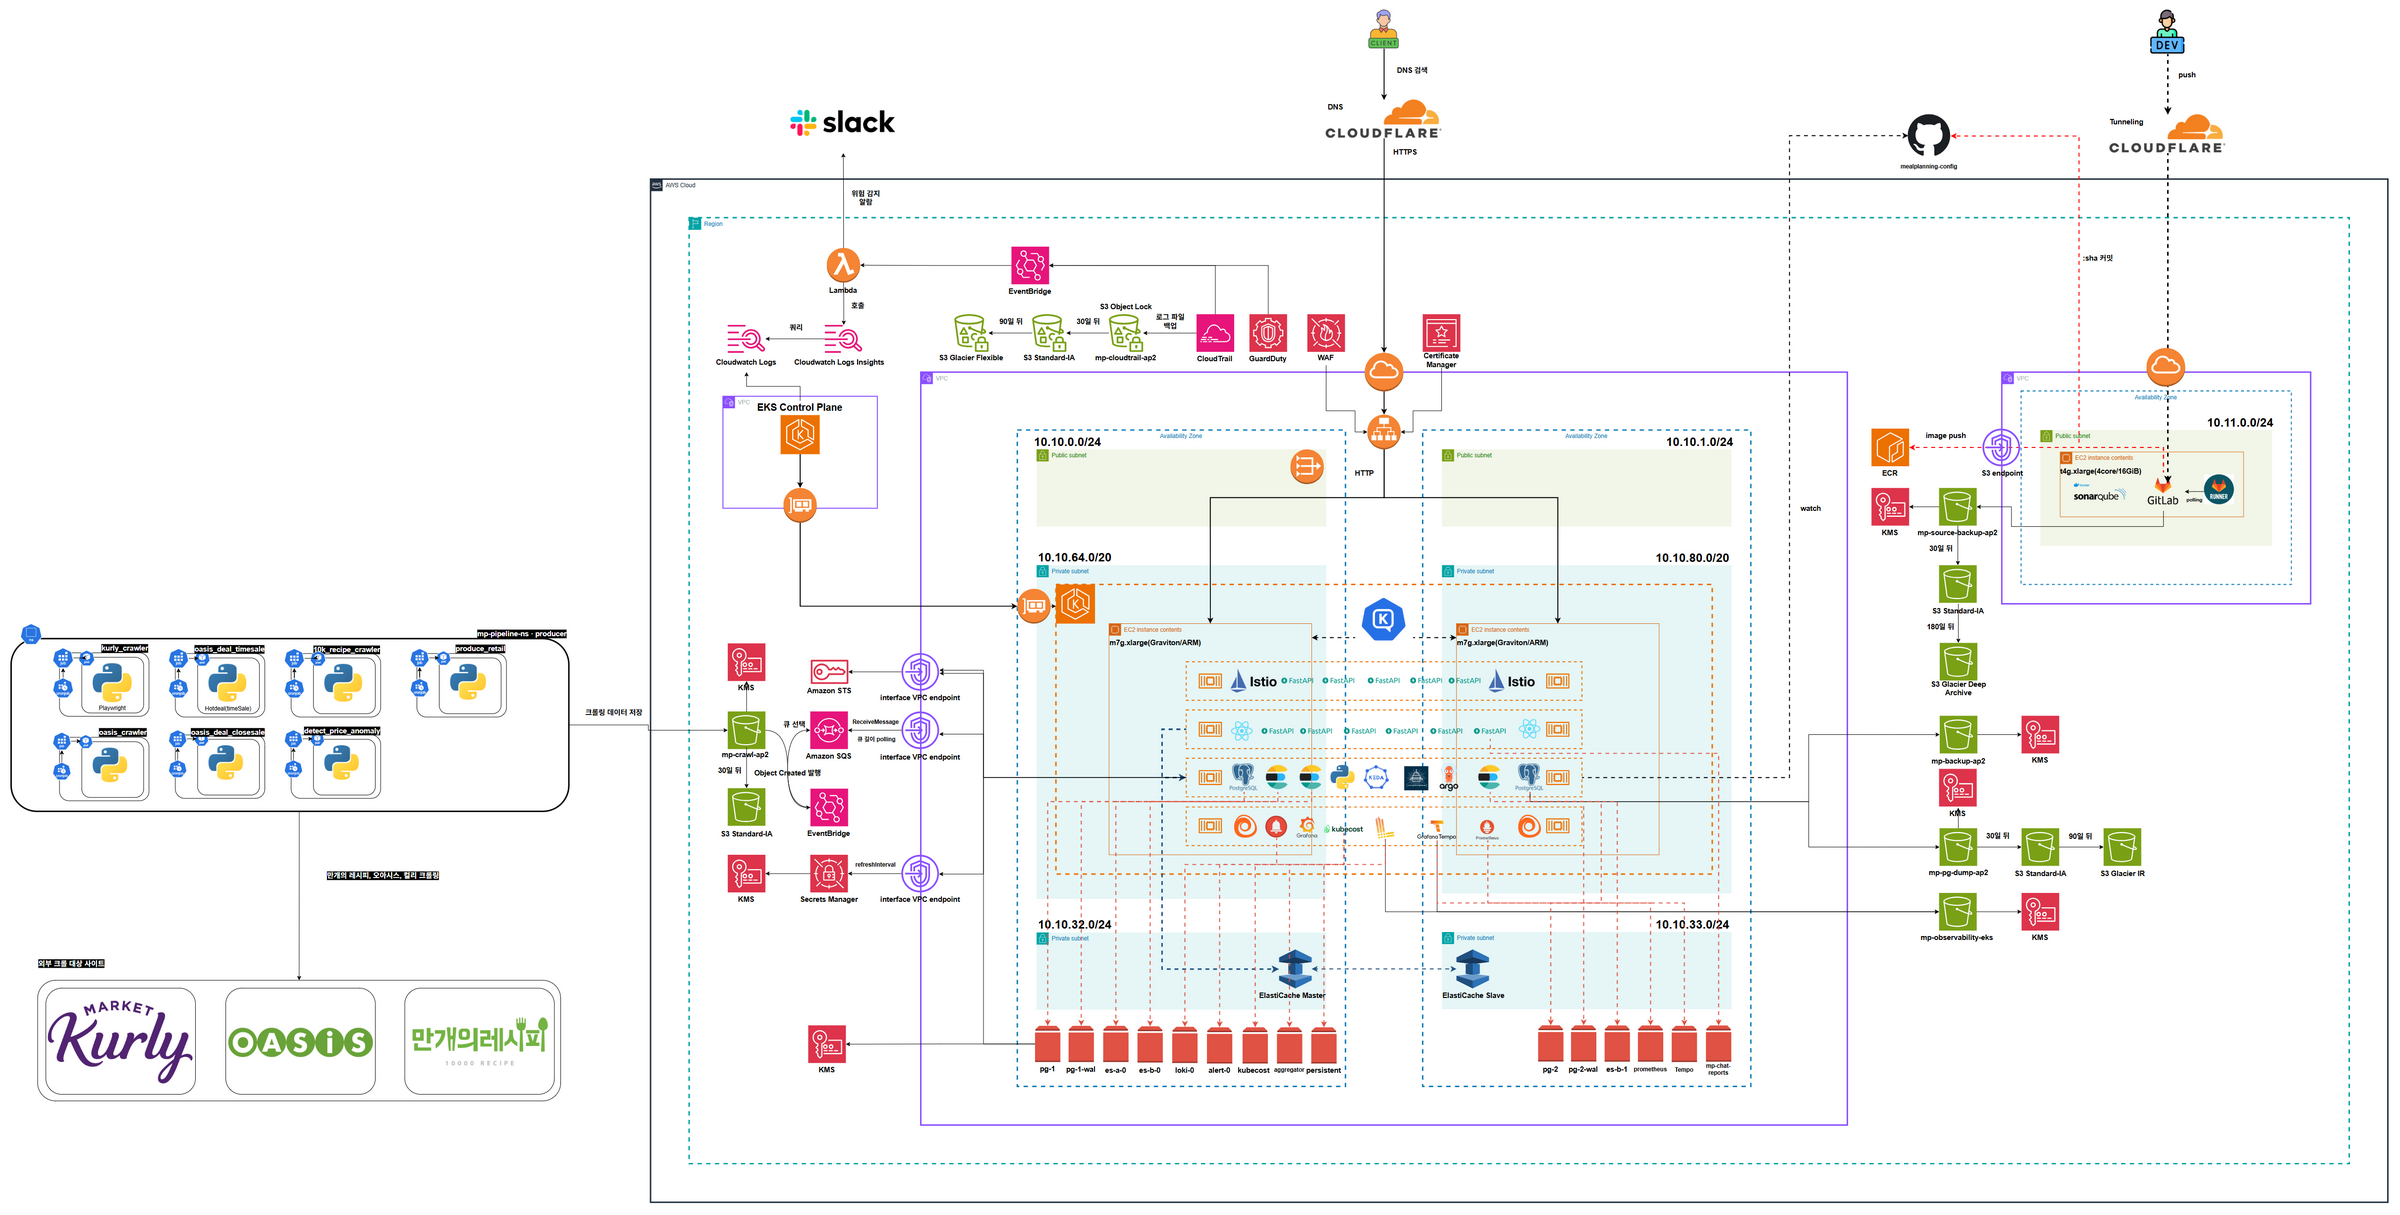
AWS 설계도: VPC 3단 서브넷, 진입 경로, 비동기 처리, 백업 수명주기 (클릭하면 원본 크기)부하를 건 채로 Blue-Green 전환: 헬스체크 응답이 끊기지 않는 화면 ·YouTube에서 열기
Load test · 오토스케일링 확인
부하를 올려 노드가 실제로 늘어나는지 확인
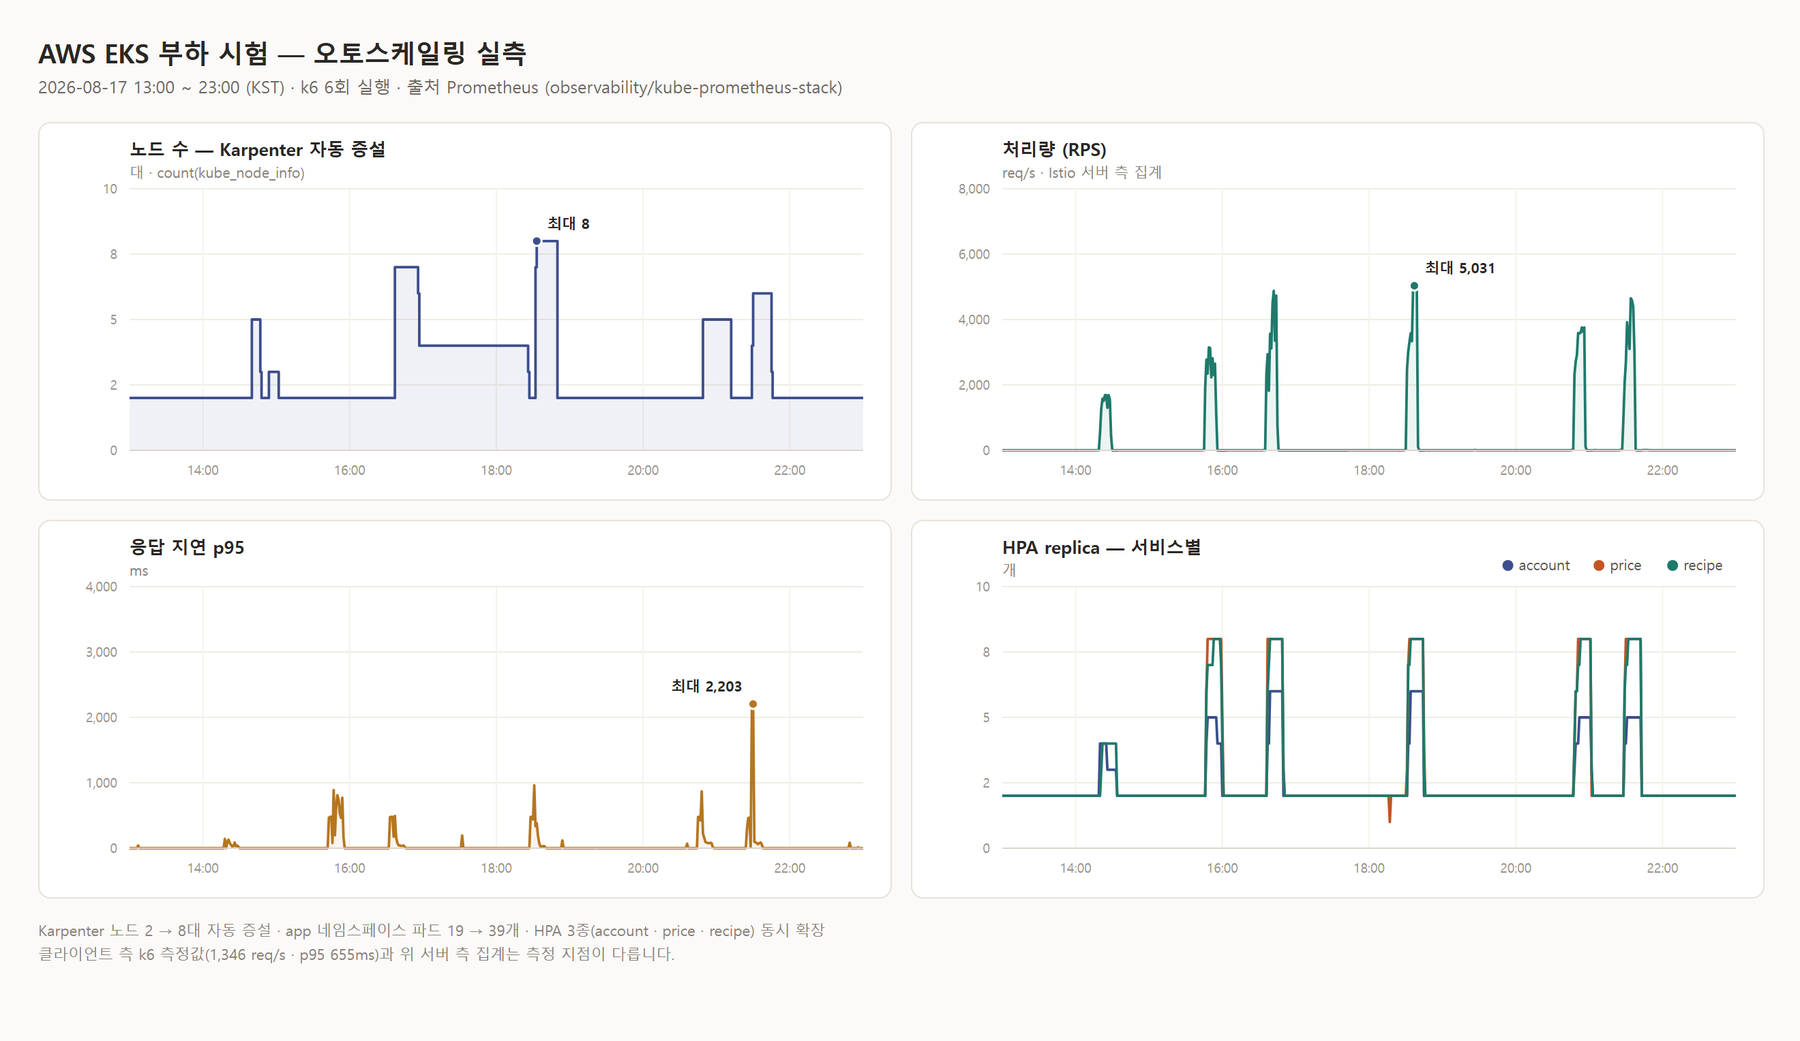
k6로 동시 사용자 1,500명 부하를 걸고 파드(HPA)와 노드(Karpenter)가 실제로 늘어나는지 확인했습니다. 같은 부하로 하루 여섯 번 돌렸고, 기록이 온전히 남은 4회차에서 초당 1,346건을 처리했고 응답 p95는 655ms, 요청 979,220건 중 실패는 12건이었습니다. 노드는 Karpenter가 2대에서 최대 8대까지 늘렸습니다. 부하와 따로 파드 하나만 띄워 재 보니, 파드가 대기 상태가 된 뒤 새 노드에서 실행되기까지 51초가 걸렸습니다.
2026-08-17 하루 여섯 번 돌린 시험 전체의 노드 수와 HPA replica 변화. 처리량 그래프는 Istio가 서비스 사이 호출까지 함께 센 값이라 k6 기준 수치보다 큽니다
Decisions · 단계마다 내린 판단
기록한 설계 결정 89건 중 일곱 가지
설계하면서 내린 결정은 번호를 붙여 기록했습니다. 고른 방법뿐 아니라 검토했다가 안 쓴 방법과 그 이유도 같이 남겼습니다.
EKS 네트워크는 ENI 모드↔ 온프렘과 같은 오버레이
AI 도구로 처음 설계를 정리할 때는 온프렘과 같은 오버레이로 잡았습니다. 구축 전에 근거를 하나씩 다시 확인하다가, EKS는 API 서버가 AWS 쪽에 있어 오버레이 파드에 닿지 못한다는 걸 찾았습니다. 그대로 갔다면 웹훅을 쓰는 컴포넌트(CloudNativePG, Istio 주입 등) 다섯 개가 동작하지 않았을 겁니다. 그래서 파드가 VPC 주소를 받는 ENI 모드로 구축했고, 그 뒤로는 AI가 낸 설계도 구축 전에 근거부터 확인합니다.
데이터 계층은 자체 운영↔ RDS · OpenSearch · MSK
비용 부담도 있었고, 오퍼레이터로 데이터베이스를 직접 운영해 보는 경험을 쌓고 싶었습니다. AWS로 옮긴 뒤에도 유지했고, Redis만 따로 판단해 ElastiCache로 넘겼습니다(아래).
Redis는 ElastiCache for Valkey↔ Sentinel 자체 운영 유지
Redis에 든 건 전부 다시 만들 수 있는 캐시와 짧은 작업 상태였습니다. 반면 Sentinel은 노드가 죽었을 때 마스터 주소가 갱신되지 않는 문제로 이미 한 번 장애를 냈고, 그 우회 코드가 앱에 남아 있었습니다. 그래서 비용보다 운영 부담을 기준으로 ElastiCache로 넘겼습니다. 엔진은 Redis와 명령이 호환되고 20% 저렴한 Valkey를 골랐고, 앱은 Sentinel 없이 붙는 설정이 이미 기본값이라 코드를 바꾸지 않았습니다.
NAT 게이트웨이 1대 + 엔드포인트 3곳↔ 가용영역마다 NAT
가용영역마다 NAT를 두는 대신 1대로 줄여 월 약 $86를 아꼈습니다. 대신 그 가용영역이 멈추면 두 영역 모두 밖으로 나가는 길이 끊기는데, 그때 가장 치명적인 세 곳만 VPC 엔드포인트(월 약 $57)로 따로 열어 두었습니다. 파드의 AWS 권한 갱신(STS), 크롤링 결과 처리 큐(SQS), 비밀 값 갱신(Secrets Manager)입니다.
컴퓨트는 온디맨드↔ Spot
Blue-Green에서는 새로 띄운 쪽이 곧 운영 서비스가 되기 때문에, 중간에 회수될 수 있는 Spot은 쓰지 않았습니다. 배포나 부하 때만 노드를 잠깐 늘리는 구조라 Spot으로 아낄 수 있는 금액도 작았습니다.
외부 진입은 ALB↔ NLB 패스스루
처음에는 온프렘과 같은 모양으로 Cloudflare 뒤에 NLB를 두려 했는데, 그러면 Cloudflare와 AWS 두 곳을 모두 지켜야 했습니다. 입구를 ALB 하나로 모으고 인증서(ACM)와 방화벽(WAF)을 AWS에서 관리하게 바꿨습니다.
배포는 Canary에서 Blue-Green으로↔ 전면 Canary · 롤링 유지
온프렘에서 Blue-Green을 뺀 이유는 메모리 부족 하나였습니다. 그래서 AWS에서 Karpenter로 노드를 늘릴 수 있게 되자, 같은 문제를 다시 검토해 Blue-Green으로 바꿨습니다.
Retrospective · 다시 한다면
앱을 기능별 네임스페이스로 나누기
지금은 앱이 전부 app 네임스페이스 하나에 모여 있습니다. 네임스페이스 사이 통신은 막았지만, 같은 네임스페이스 안의 앱끼리는 기능 단위로 나누지 못했고, 팀원별 RBAC도 결국 앱 전체를 한 덩어리로 다뤘습니다. 다시 한다면 계정, 레시피, 가격처럼 기능별로 네임스페이스를 나누고, 통신 허용과 권한도 그 단위로 걸겠습니다. 그러면 한 기능에 문제가 생겨도 영향이 그 안에서 멈추고, 담당자에게도 그 기능에 필요한 권한만 줄 수 있습니다.
에러가 보인 곳과 원인이 달랐던 장애
Troubleshooting
네 건 모두 문제가 보인 곳과 실제 원인이 있는 곳이 달랐습니다. 그래서 원인을 짐작하면 바로 고치지 않고, 그게 맞다면 같이 보여야 할 다른 흔적이 실제로 있는지부터 확인합니다.
CPU가 남는데 파드가 뜨지 않은 문제
증상: 노드 CPU 부족→원인: 실측 없이 잡힌 예약값
증상
EKS에 앱을 올렸는데 전부 초기화 단계에서 멈췄습니다. Istio 컨트롤 플레인(istiod)이 앱 파드에 밀려 사라졌고, 다시 뜨려 해도 Insufficient cpu로 자리를 받지 못했습니다. 그런데 노드의 CPU 실사용률은 10% 남짓이었습니다.
단서
스케줄러는 파드가 실제로 쓰는 양을 보지 않고, 미리 잡아 둔 예약값(requests)의 합으로 노드에 자리가 있는지 계산합니다. 노드 CPU의 94%가 예약돼 있었는데 실제 사용은 6.5%였습니다.
원인
Istio 차트 기본값 같은 값들이 실측 없이 그대로 들어가 있었습니다. 사이드카마다 잡힌 CPU 예약이 쌓여 노드 CPU의 4분의 1 가까이를 차지했고, istiod는 크게 예약해 놓고 거의 쓰지 않았습니다. 게다가 istiod의 우선순위가 앱보다 낮아서, 앱이 뜨려면 istiod가 필요한데 istiod가 그 앱에 밀리는 교착이 생겼습니다.
조치
istiod에 시스템 우선순위를 주고, 실측이 분명한 사이드카·istiod·istio-cni·Karpenter의 CPU 예약을 줄여 약 2코어를 돌려받았습니다. 예약값은 상한이 아니어서 성능은 그대로였고, 메모리 예약은 OOMKill 위험 때문에 건드리지 않았습니다.
그 뒤로는 사용률이 낮은데 파드가 안 뜨면 노드의 예약 합계부터 봅니다. 다른 환경에서 가져온 값은 그 근거가 여기서도 맞는지 확인하고 씁니다.
파드가 VPC 외부로 통신하지 못한 문제
증상: 인증 실패→원인: CNI 인터페이스명
증상
EKS로 옮긴 뒤 일부 파드에서 외부 API 호출이 응답 없이 타임아웃으로 끝났습니다. 로그에는 인증 실패처럼 보이는 메시지가 남아 처음에는 IAM 권한을 의심했습니다.
단서
같은 Deployment의 파드인데 일부만 실패했습니다. 일부만 안 된다면 되는 쪽과 안 되는 쪽을 가르는 무언가가 있다는 뜻이었습니다.
원인
Cilium의 마스커레이드 대상 인터페이스를 eth0으로 지정했는데, AWS Nitro 인스턴스의 실제 인터페이스 이름은 ens5였습니다. 1차 ENI에 배치된 파드만 정상이었고, 2차 ENI 이후 파드는 출발지 주소가 변환되지 않아 밖으로 나가지 못했습니다.
조치
인터페이스 패턴을 en+로 바꿔 해결했습니다.
그 뒤로는 로그에 인증 오류가 찍혀도 키를 다시 발급하기 전에 통신 경로부터 확인합니다. 일부만 안 될 때는 되는 쪽과 안 되는 쪽이 무엇이 다른지부터 찾습니다.
파드 하나에 노드가 세 대 뜬 문제
증상: 노드 과다 생성→원인: 기동 중 표시 누락
증상
Karpenter가 노드를 제때 띄우는지 보려고 CPU를 크게 잡은 파드 하나를 띄웠는데, 파드 하나에 노드가 세 대 떴습니다.
단서
이벤트를 시간순으로 보니, Karpenter가 파드를 새 노드에 지명해 두는 시간은 20초인데 그 노드가 파드를 받을 수 있게 되기까지는 45초가 걸렸습니다. 지명이 풀릴 때마다 아직 자리가 없다고 보고 한 대씩 더 띄운 것이었습니다.
원인
새 노드가 아직 준비 중이라는 표시(startupTaints)를 NodePool에 적지 않았습니다. 이 표시가 있으면 Karpenter는 기동 중인 노드를 곧 쓸 수 있는 자리로 세고 더 띄우지 않습니다. 같은 이유로 Cilium이 준비되기 전에 파드가 노드에 앉을 수도 있었습니다.
조치
Cilium이 준비되면 스스로 지우는 표시(node.cilium.io/agent-not-ready)를 startupTaints로 넣어 한 대만 뜨게 했습니다.
노드 수에 상한을 걸어 둬서, 이런 과다 생성은 비용 낭비로 끝나지 않고 정작 필요한 파드를 대기 상태에 가둘 수 있었습니다. 그 뒤로는 오토스케일링을 확인할 때 몇 대가 늘었는지까지 봅니다.
매니페스트 레포지토리 충돌
증상: 협업 충돌→원인: CD 도구의 파일 처리
증상
매니페스트 레포에서 대부분의 PR이 충돌하고 주석이 계속 늘어났습니다. 팀원들끼리 누가 지웠는지 서로 의심하는 분위기가 생겼습니다.
원인
누가 고쳤는지 찾기 전에 언제 생기는지부터 확인했더니 CD가 실행된 뒤에만 생겼습니다. CD가 이미지 태그를 바꿀 때 쓰는 kustomize edit이 파일을 다시 쓰면서 키 순서와 주석 위치를 바꾸고 있었습니다.
조치
팀원들과 커밋 이력을 같이 열어 자동화 도구가 파일을 바꾸고 있었다는 걸 확인하고, 구조를 고쳤습니다.
제가 제안한 배포 구조에서 생긴 문제였습니다. 언제 생기는지부터 잡고 나니 팀 안의 논의도 금방 정리됐습니다.
그 외 프로젝트
Projects
더존 클라우드 DX Academy 6기 과정에서 리눅스·데이터베이스·컨테이너·Kubernetes 순으로 진행한 팀 프로젝트입니다.
한정판 스니커즈 거래 플랫폼 Kubernetes 인프라
2026.05 – 06 · 3명
인프라 리드: 클러스터 설계·구축, 서비스 메시, 보안, 모니터링 스택, 오토스케일링, 부하 테스트